API generasi gambar di KoboiLLM mengikuti standar OpenAI Images API,
sehingga library OpenAI maupun LiteLLM yang ada bisa langsung dipakai. Panduan
ini menjelaskan cara memanggil endpoint, parameter yang tersedia, contoh kode
untuk berbagai bahasa, struktur respons, dan estimasi biaya untuk semua
model image generation yang didukung (OpenAI gpt-image-*, Google Gemini,
dan Google Imagen).
Gunakan base URL ini pada SDK; path endpoint lengkap tercantum di bawah.
Endpoint utama:
Method
Path
Fungsi
POST
/v1/images/generations
Buat gambar baru dari prompt teks
POST
/v1/images/edits
Edit / modifikasi gambar yang sudah ada
Otentikasi menggunakan header Authorization: Bearer <API_KEY>. API key
diberikan saat pembuatan akun. Simpan di environment variable, jangan
hard-code di source code.
Terminal window
exportLITELLM_API_KEY="sk-xxxxxxxxxxxxxx"
2. Model dan Referensi Harga
Untuk contoh saat ini, pilih model aktif seperti gpt-image-2 pada Daftar Model atau Contoh Kode. Nama lain di bawah merupakan contoh historis dan belum tentu tersedia.
Ketersediaan: Deployment Imagen saat ini diblokir dan disembunyikan dari dashboard baru. Contoh Imagen di bawah adalah referensi, bukan pilihan yang dapat digunakan saat ini. Pilih model gambar aktif pada katalog akun Anda.
⚠️ Disclaimer Harga
Tarif yang tercantum di dokumen ini diambil dari halaman pricing resmi
OpenAI dan
Google Cloud Vertex AI,
diverifikasi empiris pada Mei 2026 dengan menjalankan request ke
setiap model dan mencocokkan dengan billing API masing-masing provider.
Provider bisa mengubah harga kapan saja tanpa notifikasi panjang.
Selalu verifikasi tagihan aktual di dashboard
dashboard.koboillm.com (lihat §8).
2.1 — Model OpenAI
Model
Endpoint name
Billing
Cocok untuk
gpt-image-1-mini
gpt-image-1-mini
per-token
Thumbnail, generasi massal, prototipe — paling murah
gpt-image-1.5
openai/gpt-image-1.5
per-token
General-purpose, balance kualitas & harga — rekomendasi default
gpt-image-2
openai/gpt-image-2
per-token
Model terbaru, prompt adherence terbaik, detail kompleks
gpt-image-1
openai/gpt-image-1
per-token
Versi legacy, tarif sama dengan gpt-image-1-mini family
chatgpt-image-latest
openai/chatgpt-image-latest
per-token
”ChatGPT-style” dengan reasoning step — paling mahal, ~3× gpt-image-1.5
dall-e-3
openai/dall-e-3
per-image flat
Model legacy DALL·E 3
dall-e-2
dall-e-2
per-image flat
Model legacy DALL·E 2
2.2 — Model Google Gemini (token-based)
Model
Endpoint name
Cocok untuk
gemini-2.5-flash-image
gemini/gemini-2.5-flash-image atau vertex_ai/gemini-2.5-flash-image
Image gen via Gemini, murah & cepat — rekomendasi Gemini
gemini-3.1-flash-image
gemini/gemini-3.1-flash-image-preview atau vertex_ai/gemini-3.1-flash-image-preview
Versi preview lebih baru, ~1.7× lebih mahal dari 2.5-flash
gemini-3-pro-image
gemini/gemini-3-pro-image-preview atau vertex_ai/gemini-3-pro-image-preview
Versi Pro, kualitas tertinggi di Gemini family, ~3.5× lebih mahal dari 2.5-flash
Model gemini/... dan vertex_ai/... adalah dua route yang sama ke
backend. Pakai yang mana saja — keduanya menggunakan kredensial Vertex AI
dan ditagih dengan tarif identik.
2.3 — Model Google Imagen (per-image flat fee)
Model
Endpoint name
Tarif per gambar
Cocok untuk
imagen-3.0-fast-generate-001
vertex_ai/imagen-3.0-fast-generate-001
$0.02
Imagen 3.0 speed-optimized — paling murah
imagen-4.0-fast-generate-001
vertex_ai/imagen-4.0-fast-generate-001
$0.02
Imagen 4.0 speed-optimized
imagen-3.0-generate-001
vertex_ai/imagen-3.0-generate-001
$0.04
Imagen 3.0 standard v1
imagen-3.0-generate-002
vertex_ai/imagen-3.0-generate-002
$0.04
Imagen 3.0 standard v2
imagen-3.0-capability-001
vertex_ai/imagen-3.0-capability-001
$0.04
Imagen 3.0 untuk inpainting/editing
imagen-4.0-generate-001
vertex_ai/imagen-4.0-generate-001
$0.04
Imagen 4.0 standard
imagen-4.0-ultra-generate-001
vertex_ai/imagen-4.0-ultra-generate-001
$0.06
Imagen 4.0 ultra — kualitas tertinggi
Imagen menggunakan tarif tetap per-gambar (tidak per-token). Resolusi dan
parameter lain tidak mempengaruhi biaya — n=1 selalu pakai tarif di atas,
n=4 × tarif tersebut.
2.4 — Cara Memilih Model
Pilih model aktif melalui Daftar Model atau Contoh Kode. Periksa jenis model, akses key, serta parameter yang didukung. Contoh generasi/edit OpenAI di bawah menggunakan gpt-image-2; jangan memilih model historis hanya karena tercantum pada tabel harga.
Harga pada tabel adalah referensi provider, bukan penawaran saldo pelanggan. Lihat biaya request yang tercatat di Log, termasuk aturan gambar, cache, tier, dan markup yang berlaku. Imagen tetap tidak tersedia sampai diaktifkan oleh platform.
Mempengaruhi output token count. high ≈ 15× lebih banyak token dari low (OpenAI only).
n
int
1–10
Jumlah gambar. Cost multiplies linearly.
response_format
string
Omit atau b64_json
GPT Image 2 dan Gemini image mengembalikan b64_json, termasuk jika klien mengirim url; tidak ada URL gambar yang dihosting.
Untuk /v1/images/edits saja:
image
file/multipart
PNG/JPEG
Counted as image_input tokens
mask
file/multipart
PNG
Same rate as image
Catatan untuk Gemini: Gemini 3.1 Flash Image dan Flash-Lite Image mengabaikan quality; high tidak memilih resolusi lebih tinggi. Sebaiknya hilangkan parameter ini dan gunakan konfigurasi gambar native yang didukung bila diperlukan. Parameter lain yang tidak didukung tetap dapat ditolak.
Catatan untuk Imagen: parameter quality dan size tidak mempengaruhi biaya (flat fee per-gambar).
Model Gemini menerima aspect ratio 1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4,
9:16, 16:9, dan 21:9. Parameter quality tidak digunakan di Gemini —
hanya OpenAI yang membedakan low/medium/high.
4.6 — Contoh dengan model Imagen
Imagen pakai endpoint yang sama, tapi tarifnya flat per-gambar (tidak per-token):
prompt="Pantai tropis dengan air biru jernih dan pohon kelapa, gaya fotografi",
n=1,
size="1024x1024",
quality="high",
api_base="https://api.koboillm.com/v1",
api_key= os.environ["LITELLM_API_KEY"],
)
image_data = response.data[0]
if image_data.url:
img_bytes = requests.get(image_data.url).content
elif image_data.b64_json:
img_bytes = base64.b64decode(image_data.b64_json)
display(Image(data=img_bytes))
withopen("hasil.png","wb") as f:
f.write(img_bytes)
print(f"💾 Tersimpan ke hasil.png ({len(img_bytes)} bytes)")
print(f"📊 Usage: {response.usage}")
5. Edit Gambar yang Sudah Ada
Endpoint /v1/images/edits menerima gambar input + prompt teks. Cocok untuk:
Mengubah warna / tekstur bagian gambar
Menambah atau menghapus elemen
Memperluas (outpaint) gambar di luar frame
Membuat variasi dari satu gambar referensi
⚠️ /v1/images/edits hanya support model OpenAI (gpt-image-*).
Model Gemini (gemini-2.5-flash-image) tidak support endpoint ini —
LiteLLM menggunakan endpoints.predict API yang tidak kompatibel dengan
publisher model Gemini. Untuk edit gambar pakai Gemini, gunakan chat
completion dengan multimodal input sebagai gantinya (lihat §5.4).
-F'prompt=Ubah warna langit menjadi ungu saat senja'\
-F"size=1024x1024"\
-F"quality=high"
5.2 — Python (LiteLLM SDK)
from litellm import image_edit
withopen("input.png","rb") as f:
response =image_edit(
model="gpt-image-2",
image= f,
prompt="Ubah warna langit menjadi ungu saat senja",
size="1024x1024",
quality="high",
api_base="https://api.koboillm.com/v1",
api_key= os.environ["LITELLM_API_KEY"],
)
5.3 — Python (OpenAI SDK)
from openai import OpenAI
client =OpenAI(
base_url="https://api.koboillm.com/v1",
api_key="sk-xxxxxxxxxxxxxx",
)
withopen("input.png","rb") as f:
response = client.images.edit(
model="gpt-image-2",
image=f,
prompt="Ubah warna langit menjadi ungu saat senja",
size="1024x1024",
quality="high",
)
Catatan:gpt-image-2 memproses input image di high fidelity, jadi
1 gambar input 1024×1024 menghasilkan ~1024 token vs ~194 token di
gpt-image-1.5. Edit dengan gpt-image-2 cenderung lebih mahal dari
sisi input image-nya.
5.4 — Edit Gambar dengan Gemini (Chat Completion)
Karena /v1/images/edits tidak support Gemini, gunakan endpoint
/v1/chat/completions dengan model gemini-2.5-flash-image dan
multimodal content (image input sebagai data URL base64):
from openai import OpenAI
import base64
client =OpenAI(
base_url="https://api.koboillm.com/v1",
api_key="sk-xxxxxxxxxxxxxx",
)
withopen("input.png","rb") as f:
b64 = base64.b64encode(f.read()).decode("utf-8")
data_url =f"data:image/png;base64,{b64}"
response = client.chat.completions.create(
model="gemini/gemini-2.5-flash-image",
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": "Ubah warna langit menjadi ungu saat senja"},
Masuk menggunakan email dan kata sandi akun, lalu pilih tim.
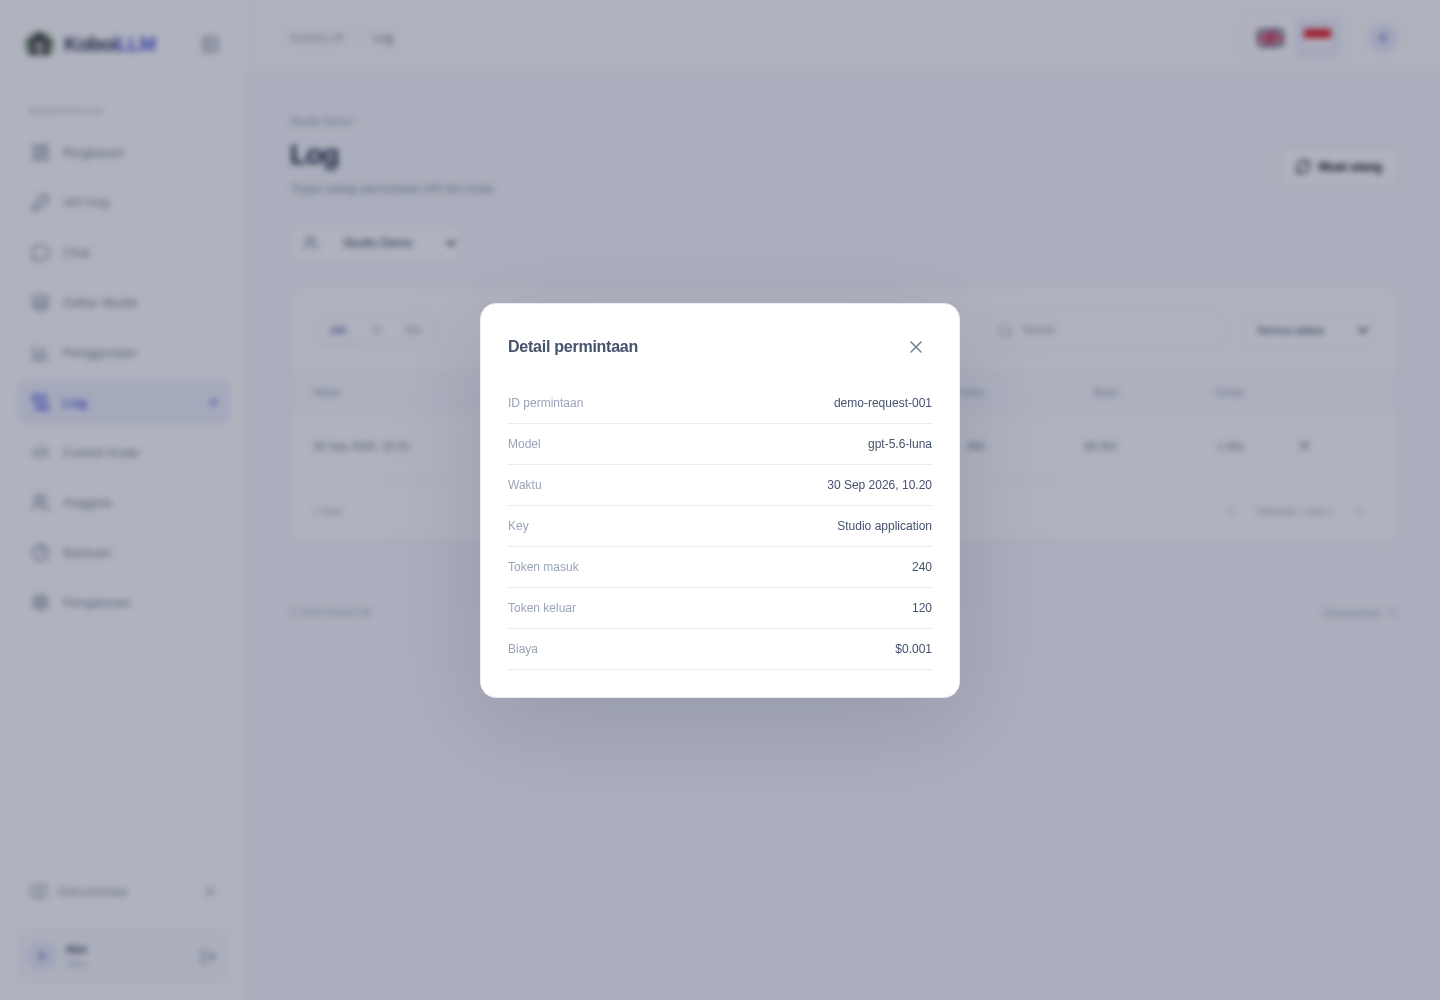
Buka Log, pilih rentang waktu, dan cari nama model yang dipakai.
Klik Lihat detail untuk melihat Request ID, token masuk/keluar, dan biaya.
Untuk ringkasan per model, buka Penggunaan. Tunggu pencatatan selesai lalu muat ulang jika request terbaru belum terlihat.
Tampilan dashboard asli dengan data contoh fiktif. Klik untuk memperbesar.
Dashboard tidak menampilkan objek mentah metadata.usage_object atau isi prompt/respons. Total token tidak selalu cukup untuk menghitung gambar, audio, cache, atau tier harga. Harga provider dalam panduan ini adalah referensi; biaya tercatat dapat mencakup markup dan aturan model. Jika ada selisih, hubungi bantuan dengan Request ID, waktu, model, dan biaya yang terlihat. ID respons provider tidak selalu sama dengan Request ID pada Log.
Request terlalu lama. Coba quality lebih rendah atau ukuran kecil dulu
Contoh struktur error
{
"error": {
"message": "Team budget exceeded: $5.00 spent of $5.00 limit.",
"type": "budget_exceeded",
"code": "403"
}
}
Retry dengan backoff (Python)
import time, random
defwith_retry(fn, max_retries=3):
for attempt inrange(max_retries):
try:
returnfn()
exceptExceptionas e:
if attempt == max_retries -1:
raise
wait = (2** attempt) + random.random()
print(f"Retry dalam {wait:.1f}s setelah error: {e}")
time.sleep(wait)
10. Tips & Best Practices
Pemilihan model
Untuk thumbnail / generasi massal → gpt-image-1-mini di low quality.
~$0.002 per gambar.
Harga konsisten (tidak naik turun per token) → Imagen series, flat fee per gambar.
Marketing / produk umum → gpt-image-1.5 di medium atau high.
Detail kompleks, prompt panjang → gpt-image-2 di high atau imagen-4.0-ultra.
Hindari chatgpt-image-latest untuk volume tinggi — biayanya bisa
10× lebih mahal dari gpt-image-1.5 setara.
Optimasi biaya
Mulai dengan quality=low untuk preview/iterasi prompt, lalu naik ke
high setelah prompt-nya pas.
n=1 lebih efisien — generate ulang manual lebih murah dari batch.
Untuk edit, gunakan gpt-image-1.5 (input image cuma ~194 token vs
~1024 token di gpt-image-2). Gemini tidak support /v1/images/edits —
gunakan chat completion multimodal seperti §5.4.
Imagen fast variants ($0.02) lebih murah dari Imagen generate ($0.04),
cocok untuk thumbnail.
Latency
low quality: 5–15 detik (OpenAI)
medium quality: 15–45 detik (OpenAI)
high quality: 30–90 detik (OpenAI, bisa lebih untuk gpt-image-2 dan chatgpt-image-latest)
Gemini: 5–60 detik tergantung resolusi
Imagen: 5–15 detik untuk fast, 10–30 detik untuk standard/ultra
Privasi & data
Jangan kirim PII (data pribadi) di prompt — semua dilewati ke provider.
Output gambar tidak disimpan di server proxy. Download segera atau
simpan ke storage sendiri jika ingin permanen.